Groupe SAMSE — Conseil expert Magento 2 : socle mutualisé, performance et audits
- Magento 2
- Performance
- Audit technique
- Architecture
Le groupe SAMSE distribue des matériaux de construction sous plusieurs enseignes — Samse, Doras, Mauris Bois, M+ Matériaux — chacune avec son site, son catalogue et ses agences. Nous accompagnons leurs équipes techniques depuis 2021, en conseil expert Magento 2 — un rôle d’expertise externe, aux côtés de leurs développeurs et des agences qui interviennent sur les projets.
Le socle mutualisé, « Magento Premium »
Le problème d’un groupe multi-enseignes est toujours le même : chaque site refait ce que le voisin a déjà fait, avec ses propres bugs. La réponse a été de construire un squelette technique commun — une bibliothèque de modules Magento 2 réutilisables d’une enseigne à l’autre :
- Agences et retrait en magasin, stocks, prix, devis, commandes, comptes clients
- Webservices et connexion aux systèmes du groupe, imports et exports
- Recherche, thème, permissions, moyens de paiement et de livraison
- Le tout versionné, distribué par Composer, et installable sur un projet neuf en quelques commandes
Concrètement, une nouvelle enseigne ne repart pas d’un Magento vide : elle démarre d’un socle éprouvé, et ne développe que ce qui lui est vraiment spécifique. Les corrections, elles, profitent à tout le monde en même temps.
Quatre sites, un seul socle
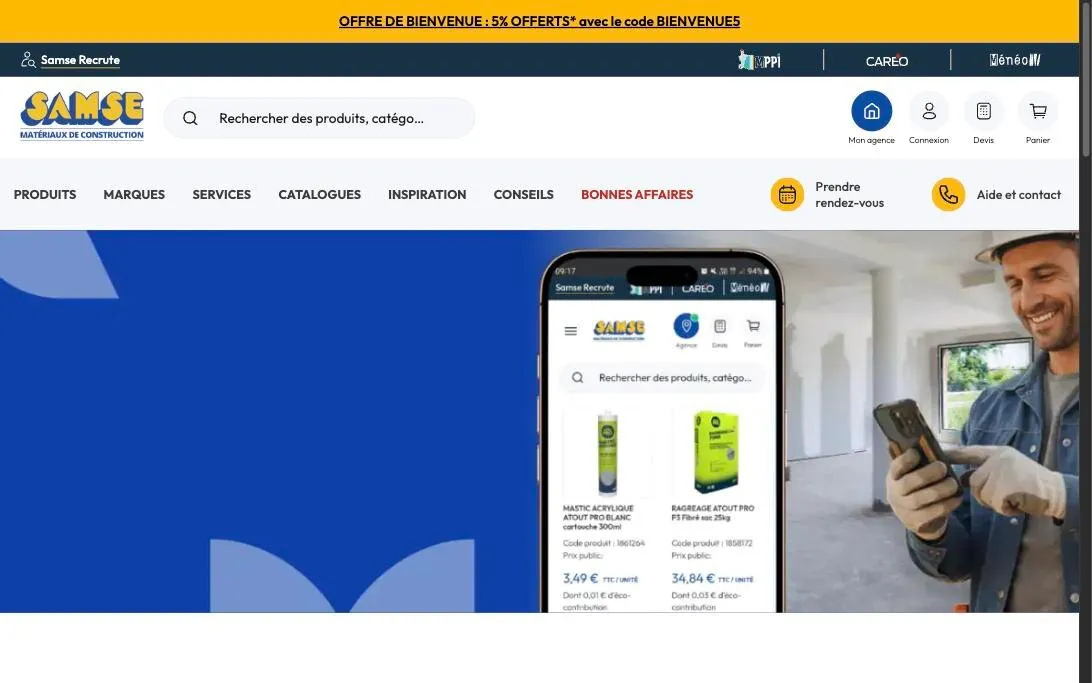
Samse, Doras, Mauris Bois et M+ Matériaux tournent sur cette même bibliothèque de modules.
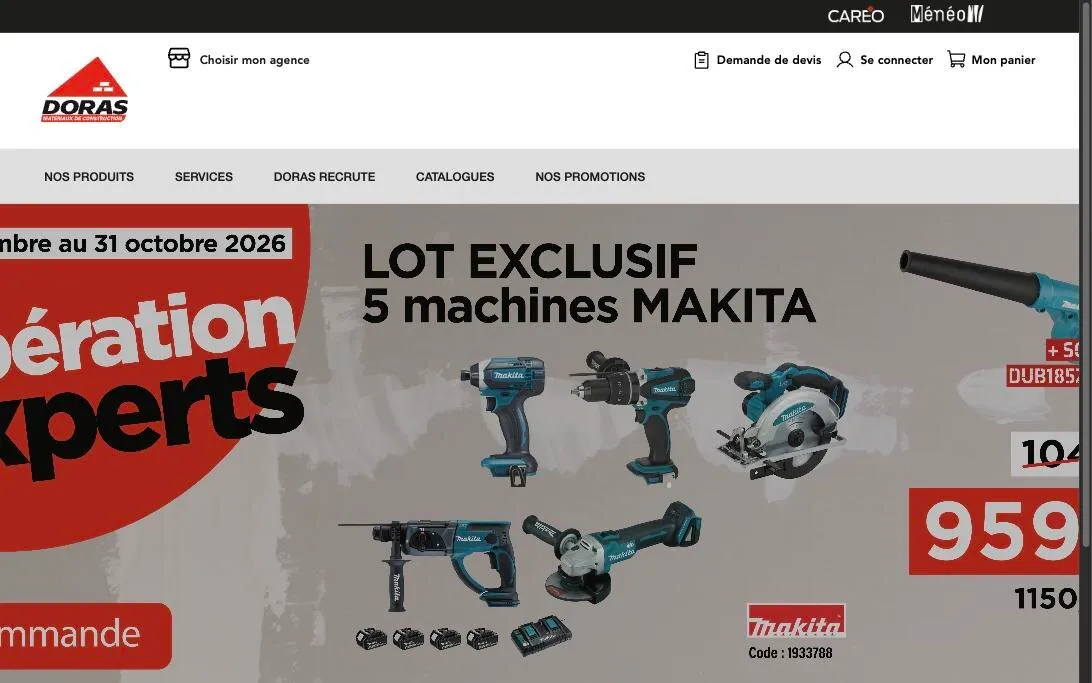
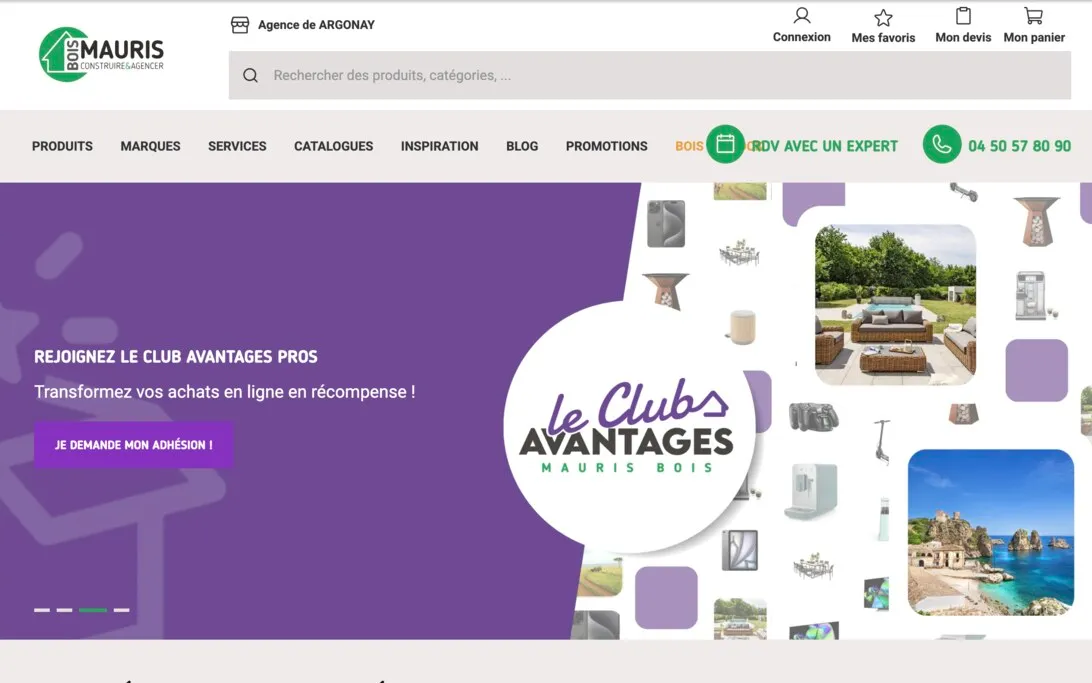
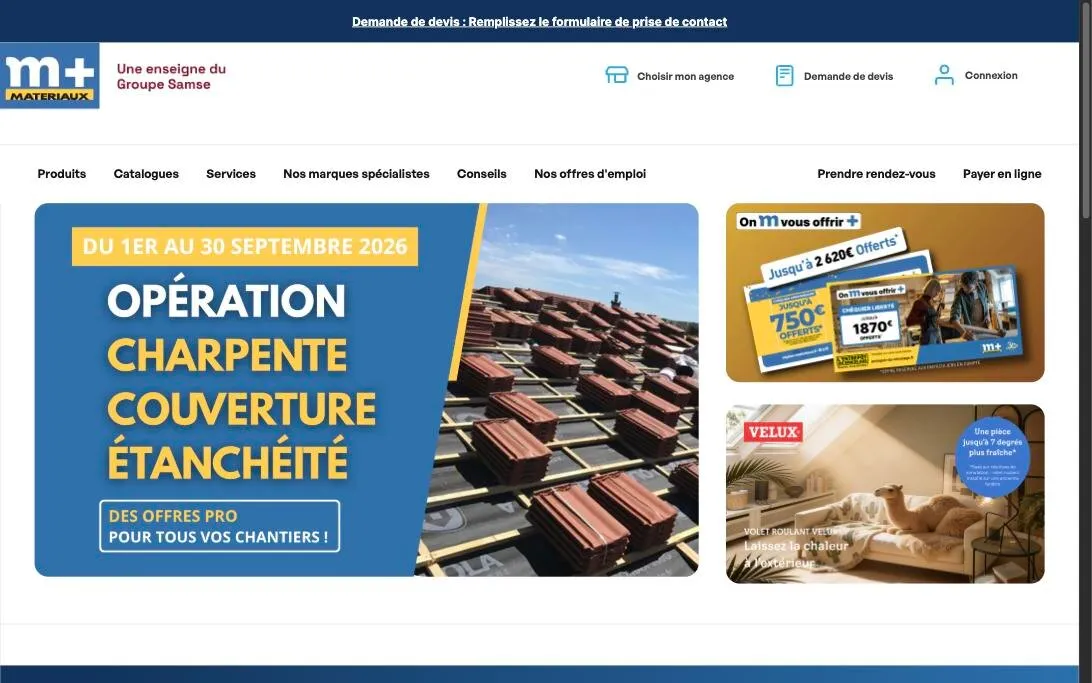
Mis côte à côte, les sites n’ont pourtant rien à voir : chacun garde son identité, son ton, sa mise en page, ses campagnes. C’est précisément l’objectif d’un socle bien découpé — mutualiser ce qui relève du métier commun, les agences et le retrait en magasin, les prix, les stocks, les devis, les comptes professionnels — et laisser à chaque enseigne ce qui fait sa différence commerciale.
La performance
Notre second terrain, c’est la vitesse — sur des catalogues de négoce, larges et très sollicités. Le travail va de la requête SQL au rendu de la page :
- Profilage PHP et analyse des piles d’appels pour trouver ce qui coûte réellement, plutôt que ce qu’on suppose
- Réécriture de requêtes SQL pathologiques, mise en cache de blocs coûteux
- Chasse au CLS provoqué par les briques tierces — moteur de recherche instantanée, chat d’assistance — qui s’insèrent après le premier rendu
- Réduction et fiabilisation des appels HTTP sortants
Le regard extérieur
Sur une plateforme de cette taille, plusieurs équipes et agences travaillent en parallèle, chacune compétente sur son périmètre. Le client souhaite simplement disposer d’un avis extérieur : un relecteur qui n’est pas dans le projet au quotidien, qui prend le temps de mesurer, et qui dit ce qu’il voit sur la qualité du code, la performance et la maintenabilité.
C’est confortable pour tout le monde, y compris pour les équipes en place : un point de vue neutre ferme les débats plus vite qu’un échange d’opinions, et donne aux développeurs un appui pour défendre les chantiers techniques qu’ils jugent nécessaires.
Un exemple : les crons qui se tuaient entre eux
La production tournait sur Upsun, avec une charge anormalement élevée et des processus tués par le système en pleine nuit. Les journaux répétaient qu’un verrou d’indexation ne pouvait pas être acquis.
Le diagnostic a demandé de remonter la chaîne : plusieurs exécutions de cron:run en parallèle —
ce qui est normal sous Magento — mais chacune démarrant ses tâches dans des processus séparés, tous
sur le même worker que les indexeurs et les consommateurs de file. La mémoire saturait, le système
tuait le processus le plus gourmand, et l’indexation s’arrêtait en plein milieu : le lendemain, les
vues étaient en retard, donc plus lourdes à rattraper, donc plus susceptibles d’être tuées à leur
tour.
La correction a consisté à séparer les responsabilités — indexation et consommateurs sortis du worker des crons — à revoir le mode d’exécution des tâches, et à neutraliser les vues indexées qui généraient un flux continu sans utilité réelle. Puis à surveiller le rattrapage du retard d’indexation, nuit après nuit, jusqu’à confirmation que plus aucun processus n’était tué.
C’est représentatif de ce type de mission : le symptôme est une alerte d’infrastructure, la cause est un choix de configuration applicative, et la réponse demande de connaître les deux.
Projets similaires
Cocolis.fr — Direction technique et refonte de la plateforme
Plusieurs millions de requêtes par mois
- Ruby on Rails
- Architecture
- Performance
Ekinsport — Connexion de Magento 2 à un nouvel ERP
- Magento 2
- Intégration ERP
Nautisports.com — Stabilisation technique et passage à Hyvä
- Magento 2
- Hyvä
- Performance